Guardrail de IA
Reduza o risco de erro e alucinação de modelos de IA orquestrando múltiplos provedores para validar a mesma informação entre si, antes de confiar no resultado.
O que é um Guardrail de IA
"Guardrail de IA" é um termo guarda-chuva para qualquer mecanismo que reduz o risco de uma IA generativa errar, alucinar ou sair do escopo pretendido. Inclui coisas bem diferentes entre si, como filtros de conteúdo, validação de schema de saída, defesa contra prompt injection e restrição de escopo via instrução de sistema. A validação cruzada entre múltiplos modelos que esta página descreve é um tipo de guardrail dentro desse conjunto maior, focado especificamente em reduzir alucinação e erro factual.
Esse tipo específico funciona assim: em vez de confiar cegamente na resposta de uma única chamada de IA, mais de um modelo/provedor checa a mesma informação, cada um atuando como verificação independente sobre os outros. Se dois modelos de fornecedores diferentes concordam sobre um dado extraído de um documento, a chance de ambos terem "alucinado" a mesma coisa, do mesmo jeito, é muito menor do que a chance de um único modelo errar sozinho.
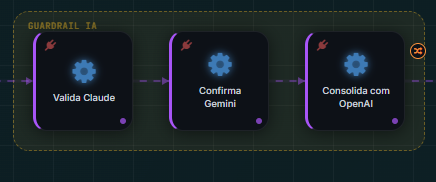
No browserMate, isso não é um recurso à parte: é uma composição de etapas de Conectar Serviços já existentes (um conector por provedor de IA), organizadas visualmente num Grupo de Etapas nomeado, seguidas de uma etapa que consolida os resultados:
Por que orquestrar múltiplos modelos
Validar a saída de um modelo de IA com outro modelo independente se apoia em três razões práticas:
- Erros não são correlacionados entre fornecedores diferentes. Claude, Gemini e GPT são treinados com dados, arquiteturas e processos de alinhamento diferentes. Quando um "alucina" um valor, é improvável que outro fornecedor, com um modelo genuinamente distinto, produza exatamente o mesmo erro. Concordância entre fornecedores independentes é um sinal de confiança muito mais forte do que rodar o mesmo modelo duas vezes.
- "LLM-as-judge" e "debate entre agentes" são técnicas publicadas e validadas. Pesquisas como "Improving Factuality and Reasoning in Language Models through Multiagent Debate" (Du et al., MIT/Google, 2023) mostram que fazer múltiplos modelos debaterem ou revisarem a resposta um do outro aumenta a precisão factual e reduz alucinação, comparado a uma única chamada isolada.
- É o mesmo princípio de ensemble. Combinar estimadores independentes reduz variância e erro, e o raciocínio vale igual para modelos de linguagem.
- Reduz o risco de concentração num único fornecedor. Um viés sistemático, uma lacuna de conhecimento ou uma instabilidade momentânea de um provedor não se propaga silenciosamente para a decisão de negócio: outro provedor, com outra base, tem chance real de discordar e sinalizar o problema.
Como montar no Agent Builder
- Cadastre um conector para cada provedor de IA que vai participar da validação, como Claude, Google Gemini, OpenAI.
- Crie uma etapa Conectar Serviços por provedor, todas recebendo a mesma entrada (o mesmo trecho de texto, documento ou pergunta) e gravando a resposta numa variável própria.
- Selecione as etapas e agrupe-as num Grupo de Etapas. Dê um nome descritivo, como GUARDRAIL IA, para deixar claro no canvas que ali é uma verificação cruzada, não uma sequência de tarefas de negócio.
- Adicione uma etapa final (Decisão ou Regra Customizada) que compara as respostas e decide o que fazer. Veja os padrões abaixo.
Padrões de consolidação
| Padrão | Como funciona | Quando usar |
|---|---|---|
| Concordância unânime | Só segue se todos os provedores derem a mesma resposta; qualquer divergência interrompe o fluxo ou pede revisão humana. | Decisões de alto risco (valores financeiros, dados regulatórios, aprovações irreversíveis). |
| Votação por maioria | Usa a resposta que aparece em pelo menos 2 dos 3 provedores; registra a divergência do terceiro para auditoria. | Bom equilíbrio entre robustez e continuidade, o que atende a maioria dos casos de guardrail. |
| Cascata por confiança | Chama primeiro o provedor mais barato/rápido; só aciona o segundo e o terceiro se a resposta vier ambígua, incompleta ou de baixa confiança. | Quando custo e latência importam e a maioria dos casos é simples o bastante para uma única chamada bastar. |
| Especialista + revisor | Um provedor extrai/gera a informação; outro, com um prompt diferente, audita especificamente a resposta do primeiro em busca de inconsistências. | Extrações complexas (documentos longos, múltiplos campos relacionados) onde um "olhar fresco" pega erros que o extrator original não percebe nele mesmo. |
Exemplo prático
Validar o valor total extraído de uma nota fiscal com os três provedores, seguindo o padrão de votação por maioria:
const claude  = bm.get('{valor_claude}', '');
const gemini  = bm.get('{valor_gemini}', '');
const openai  = bm.get('{valor_openai}', '');

const respostas = [claude, gemini, openai];
const contagem  = {};
respostas.forEach(r => contagem[r] = (contagem[r] || 0) + 1);

const maioria = Object.entries(contagem).find(([, qtd]) => qtd >= 2);

if (maioria) {
  bm.bmLog('{application_success} Guardrail: ' + maioria[0] + ' confirmado por ' + maioria[1] + '/3 provedores');
  bm.done('confirmado', { '{valor_final}': maioria[0], '{guardrail_status}': 'ok' });
} else {
  bm.bmLog('{application_warn} Guardrail: os três provedores divergiram. Claude=' + claude + ', Gemini=' + gemini + ', OpenAI=' + openai);
  bm.done('divergencia', { '{guardrail_status}': 'revisar' });
}
A etapa seguinte pode ser uma Decisão que lê {guardrail_status}: segue o fluxo normal se ok, ou desvia para uma etapa de notificação/revisão humana se revisar.
Boas práticas
- Reserve para decisões de alto impacto. Cada provedor extra soma custo e latência (veja Timers), e um guardrail de 3 chamadas de IA não compensa para extrações triviais ou de baixo risco.
- Trate a falha de um provedor como falha, não como divergência. Configure a Gestão de Erros e Exceções em cada etapa de IA. Um provedor fora do ar não deve ser contado como "discordância" no seu padrão de consolidação.
- Audite as divergências. Mesmo quando o padrão escolhido segue em frente (ex.: votação por maioria), registre o provedor que discordou em log, porque divergências recorrentes de um mesmo provedor podem indicar que ele não é adequado para aquele tipo de validação.
- Prompts equivalentes, não idênticos. Adaptar o prompt ao estilo de cada modelo (mantendo a mesma pergunta de fundo) tende a produzir validações mais independentes do que copiar e colar o mesmo texto nos três.